O chunking sintático revela uma representação sintática central de números com vários dígitos, que é gerativa e automática Parte 2
Oct 26, 2023
Codificação de dados
Cada palavra numérica é definida exclusivamente por uma classe lexical (neste experimento usamos apenas unidades, dezenas ou centenas) e um valor de 1 a 9. Por exemplo, a palavra ffty é a combinação do dígito 5 e da classe Dezenas. Da mesma forma, "quatrocentos" (presumivelmente um único valor léxico-fonológico em hebraico) é o dígito 4 na classe Centenas. Da mesma forma, a representação cognitiva de palavras numéricas está em dois morfemas, dígito e classe (McCloskey et al., 1986), portanto nossa codificação foi baseada nesses dois morfemas. A palavra decimal “mil” foi uma exceção: consideramos como um morfema único, a classe lexical “mil” sem morfema de dígito.
Existe uma relação inseparável entre codificação e memória. Codificação refere-se à conversão de informações em um formato que possa ser processado pelo cérebro humano, enquanto memória se refere ao processo de armazenamento e recuperação de informações. O processo de codificação tem um impacto crucial na produção de memória, pois determina se podemos reter informações e recuperá-las quando necessário.
De modo geral, a memória humana pode ser dividida em dois tipos: memória de curto prazo e memória de longo prazo. A memória de curto prazo geralmente só pode armazenar informações por um período mais curto, enquanto a memória de longo prazo pode armazenar informações por um período mais longo. Para a capacidade de memória de uma pessoa, a codificação é a primeira e mais importante etapa antes do armazenamento da memória. Se houver um problema com a codificação, será difícil armazenar ou recuperar as informações.
A qualidade da codificação tem um enorme impacto na memória. Se pudermos usar vários sentidos para codificação, como visão, audição, olfato, etc., podemos aumentar a eficiência da codificação da informação e tornar a memória mais forte. Ao mesmo tempo, também precisamos usar o método de “compreensão do significado” para conectar informações com informações que já existem em nossa memória de longo prazo, para que sejam mais fáceis de lembrar.
Além disso, existe uma relação entre revisão e recuperação entre codificação e memória. Rever significa voltar a ler, ouvir ou ver informações novamente depois de terem sido armazenadas, de modo que permaneçam no sistema de memória por um período relativamente mais longo. Extração refere-se a retirar informações e usá-las quando necessário. Se tivermos cuidado ao codificar, revisar e recuperar de forma eficaz, nossa capacidade de memória será bastante aprimorada.
Na vida, a maior parte de nossas informações precisa ser lembrada, incluindo informações de estudo, trabalho e vida social. Portanto, precisamos levar a sério o processo de codificação para armazenar informações de maneira eficaz em nossos cérebros. Somente dominando boas habilidades de codificação você poderá armazenar, revisar e recuperar informações melhor e melhorar sua capacidade de memória. Percebe-se que precisamos melhorar a memória, e a Cistanche deserticola pode melhorar significativamente a memória, pois a Cistanche deserticola também pode regular o equilíbrio dos neurotransmissores, como aumentar os níveis de acetilcolina e fatores de crescimento. Estas substâncias são muito importantes para a memória e a aprendizagem. Além disso, a carne também pode melhorar o fluxo sanguíneo e promover o fornecimento de oxigênio, o que pode garantir que o cérebro receba nutrientes e energia suficientes, melhorando assim a vitalidade e a resistência do cérebro..

Clique em conhecer suplementos para aumentar a memória
Definimos 3 medidas de desempenho para cada tentativa, refletindo a precisão nos morfemas de dígitos, nos morfemas de classe ou em ambos. A taxa de precisão dos dígitos foi definida como a porcentagem de dígitos estímulo que apareceram na resposta, independentemente de sua ordem e ignorando o excesso de dígitos. A palavra “mil” foi excluída desta medida. A taxa de acurácia da classe foi definida como a porcentagem de classes lexicais de estímulos que apareceram na resposta, independentemente de sua ordem e ignorando as classes excessivas. Se o estímulo incluísse uma classe lexical duas vezes (por exemplo, a classe das dezenas em "noventa mil e oitenta"), mas a resposta a incluísse apenas uma vez, ele pontuaria apenas 1 ponto de precisão em 2. Finalmente, a taxa de precisão do morfema era definida pela fusão dos dois. acima – isto é, a porcentagem de morfemas de dígitos e classes que apareceram na resposta do participante, independentemente de sua ordem. No texto abaixo, reportamos as taxas de erro de morfemas, dígitos e classes, ou seja, o complemento de 100% das taxas de acertos.
Uma quarta medida possível é a taxa de precisão das palavras – a porcentagem de palavras-estímulo que apareceram na resposta. Semelhante à taxa de precisão do morfema, esta medida considera tanto a classe quanto o dígito, mas também requer o emparelhamento correto de uma classe específica com um dígito específico. Por exemplo, repetir vinte e três como trinta e dois seria codificado como 0% de precisão da palavra e como 100% de precisão do morfema. Os resultados de precisão de palavras não são relatados aqui, mas foram essencialmente os mesmos que os resultados de precisão de morfemas.
Análise estatística
Para comparar entre duas condições, inserimos a taxa de erro de dígito, classe ou morfema de cada tentativa como variável dependente em um modelo linear misto (LMM). Participante e Estímulo eram fatores aleatórios, e a condição era um fator dentro do participante, dentro do estímulo. Nos poucos casos em que um modelo não convergiu, foi movido o fator aleatório Estímulo. Para controlar o fato de diferentes participantes repetirem estímulos de diferentes durações, o comprimento do estímulo (o número de palavras) foi inserido como uma covariável. Usamos R (R Core Team, 2019) com o pacote lme4 (Bates et al., 2015).
Para determinar se o efeito da Condição foi significativo, usamos um teste de razão de verossimilhança que comparou o LMM a um LMM que era idêntico, exceto que não incluía o Fator de Condição. Para essas comparações, relatamos a estatística de teste2 (LL1–LL0), que segue uma distribuição χ2 (LL0 e LL1 denotam as probabilidades logarítmicas do modelo reduzido e do modelo completo), e o correspondente valor p. Os graus de liberdade não são relatados como sempre foram 1. Para comparar o desempenho de um único participante entre duas condições, utilizamos o mesmo método, mas o modelo não incluiu os fatores Participante e Comprimento do Estímulo; incluía apenas Estímulo como fator aleatório e Condição como fator dentro do estímulo. Como tamanho do efeito, foi relatado o coeficiente do fator de condição no modelo. Este coeficiente está próximo da diferença entre as médias das condições, por isso é denotado como Δ.
Resultados
Quatro participantes executaram a 7-versão em palavras da tarefa e os participantes restantes executaram a6-versão em palavras.

A previsão simplista do agrupamento sintático é que se um estímulo tiver mais segmentos gramaticais ou mais longos, ele deverá ser mais fácil de lembrar. Contudo, segmentos mais longos podem ser desvantajosos se forem demasiado longos; tais segmentos podem resultar na criação de mega-pedaços que excedem o limite de capacidade da memória de trabalho e são difíceis de lembrar. Assim, espera-se que a relação entre o tamanho do segmento e o desempenho tenha uma forma de U invertido: o melhor desempenho não deve estar nos estímulos com os segmentos mais longos, mas nos estímulos cujo comprimento do segmento oferece um equilíbrio ideal entre o número de pedaços e o tamanho do pedaço.
Condições com muitos segmentos gramaticais muito curtos induziriam relativamente poucos pedaços e levariam a estratégias de memória ineficazes; e condições com poucos segmentos e muito longos encorajariam a criação de pedaços superdimensionados e difíceis de lembrar. Como a Figura 2 mostra claramente, este foi precisamente o caso: a precisão foi mais alta na condição B e mais baixa nas outras condições. Em particular, a taxa de erro na condição B foi significativamente maior do que na condição C, que por sua vez teve significativamente mais erros do que na condição D – um efeito claro da fragmentação sintática. Ou seja, embora os participantes não tenham recebido instruções específicas sobre estratégias de agrupamento, eles ainda usaram a estrutura sintática do número e criaram blocos que representam números gramaticais com vários dígitos. Como esperado, o desempenho ideal não ocorreu na condição A, na qual os segmentos gramaticais eram mais longos, mas na condição B, que parece oferecer o equilíbrio ideal entre tamanho e número de pedaços.
Suporte adicional para a ideia de chunking baseado em sintaxe vem da análise das posições específicas dentro dos estímulos em que os erros ocorreram. A Figura 3 mostra a taxa de erro de dígitos em cada posição serial para os participantes que repetiram 6-sequências de palavras (os 7-participantes de palavras foram excluídos desta análise para evitar variação relacionada ao comprimento). Se os participantes memorizassem cada estímulo como uma sequência não estruturada de palavras, a tarefa seria essencialmente uma tarefa de recordação livre. Em tal tarefa, a taxa de erro normalmente deveria ser a mais baixa para as palavras iniciais da lista e aumentar gradualmente para palavras mais abaixo na lista (um efeito de primazia), com alguma melhoria na última palavra ou palavras (um efeito de recência; Murdock, 1962).
A condição D, a condição fragmentada, mostra esse padrão de tarefas de recordação livre não estruturadas. Em contraste, as condições A e B mostram um padrão diferente, indicando que factores adicionais estavam em jogo aqui, para além dos efeitos de primazia e de recência. Por exemplo, na condição B a taxa de erro diminuiu da 2ª palavra (milhares) para a 3ª palavra (centenas). Para examinar o padrão em cada condição, analisamos a precisão dos dígitos em cada palavra numérica nos 6-números de palavras, excluindo a palavra "mil" (para a qual nenhum dígito foi codificado) e excluindo a última palavra diferente de mil em cada número (para evitar o efeito de recência).
Submetemos a precisão dos dígitos de cada condição separadamente a um modelo logístico linear misto com o Participante como fator aleatório e a posição serial da palavra como fator numérico dentro do participante. Não adicionamos o Estímulo como um fator aleatório porque tal modelo atingiu um ft singular em algumas condições, mas os resultados foram essencialmente os mesmos quando incluímos este fator. O efeito da posição da palavra foi significativo na condição D (χ2=27.4, p<0.001) but only barely significant in conditions A (χ2=4.7, p=0.03) and B (χ2=4.2, p=0.04)— unimpressive significance levels that do not withstand a multiple-comparison correction. To show that the difference between conditions was significant, we submitted the data of all conditions together to the same LLMM, now adding the Condition (A/B versus D) and the Condition × Word Position interaction as within-participant factors. The interaction term was significant (χ2=11.5, p<0.001, odds ratio=0.75).
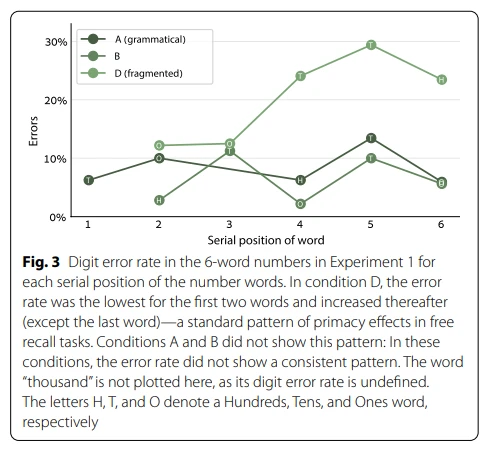
A simples recordação serial não pode explicar os resultados nas condições A e B, no entanto, o chunking sintático oferece uma explicação simples para esse padrão: na condição D, os participantes lembraram cada estímulo como uma lista não estruturada de palavras, mas nas condições A e B eles tenderam a memorizar cada estímulo. como pedaços. Por causa dessa divisão, a tarefa não era uma tarefa simples de recall em série, portanto não mostrou um efeito padrão de primazia e atualidade. Curiosamente, nas condições A e B foi observado um efeito de primazia não apenas para a sequência como um todo: em ambas as condições, o desempenho na palavra #4 foi melhor do que no termo anterior e no seguinte, e as palavras 4–5–6 mostraram um desempenho inverso. Padrão em forma de U. Esse padrão está de acordo com a ideia de que as palavras 4–5–6 foram codificadas como um bloco separado, com seus próprios efeitos de primazia e atualidade na primeira e na última palavra do bloco.
The syntactic chunking pattern—better performance in the more-fragmented conditions, and optimal performance in an interim condition—was observed not only at the group level but even for individual participants. Numerically, each of the participants showed better performance in condition B (optimal chunking) than in condition D (maximum fragmentation) (Fig. 4). This difference was significant for all participants except one (morpheme accuracy rate of each of these participants: paired t(19)>1.73, Bonferroni – Holm corrigido p unicaudal<0.05). Because the different conditions used the same stimuli and manipulated only the word order within each stimulus, we could also compare matched pairs of stimuli and show that a syntactic chunking effect existed even for single stimuli in most cases: Morpheme accuracy was better in condition D than in B only for 6% of the stimuli (and better in B for 63.5%; same in B and D for 30.5%). Nevertheless, the participants also differed from each other—the best-performance condition was different for different participants: For 13 participants, the optimal condition was B, but for 6 participants it was A and for one participant it was C (bottom panels in Fig. 4).

Discussão
O melhor desempenho foi na condição B, em que cada estímulo era um par de 3-palavras ou 4-segmentos de palavras. Nas condições C e D, o desempenho deteriorou-se à medida que o estímulo incluiu mais segmentos gramaticais mais curtos. Este efeito de agrupamento sintático indica que os participantes criaram uma representação da estrutura sintática de números inteiros, e esta representação permitiu-lhes criar blocos cada vez mais longos para segmentos gramaticais cada vez mais longos.
O melhor desempenho não foi na condição A, que tinha um único segmento longo por estímulo, mas na condição B. Ou seja, embora o desempenho tenha melhorado da condição D para C e de C para B, segmentos mais longos (na condição A) atrapalharam a memorização. Este padrão de resultados apoia a noção de que um chunking eficaz requer um equilíbrio ideal entre o tamanho do chunk e o número de chunks.
Parece que na condição A, os participantes usaram a estrutura sintática completa do número 5- ou 6-dígito para armazenar todas as palavras em um único bloco, e isso levou a tamanhos exagerados de blocos e, consequentemente, a uma memorização mais pobre. De acordo com esta visão, embora as taxas de erro tivessem um padrão em forma de U, o agrupamento sintático subjacente tinha um efeito monótono: segmentos gramaticais mais longos sempre levavam a blocos maiores, inclusive na condição A, mas aumentar o tamanho do bloco era benéfico apenas até um tamanho limite ideal de 3 –4 palavras por bloco, o que ocorreu na condição B. Além disso, na condição A, o aumento do fragmento prejudicou o desempenho porque os pedaços se tornaram grandes demais para os participantes lidarem com eficácia - eles excederam o limite de memória de trabalho que cada pedaço está sujeito a Cowan (2001). ). Abaixo, no Experimento 5, trazemos evidências adicionais para apoiar esta conclusão.

Nossas descobertas refutam uma interpretação alternativa que atribui a diferença entre a condição A e a condição B à magnitude numérica. Esta interpretação alternativa postula que o desempenho na condição A foi pior do que na condição B, não por razões relacionadas à sintaxe e ao agrupamento, mas porque os números na condição A eram numericamente maiores e, portanto, mais difíceis de processar (um efeito colateral). Dois aspectos de nossos dados refutam a interpretação alternativa: primeiro, ela não pode explicar o padrão de erro por posição na Fig. 3. Em segundo lugar, a interpretação alternativa prevê que 5- ou 6- 6-números de dígitos (como na condiçãoA ) será sempre mais difícil de memorizar do que um par de números mais curtos (condição B), independentemente dos números específicos. Como veremos na Experiência 5, esta previsão foi refutada.
O desempenho superior na condição B em relação à condição A leva a várias conclusões importantes. Primeiro, mostra o escopo da representação sintática de números - em particular, uma representação da sintaxe de triplos cruzados. Nas condições B, C e D, nenhum segmento gramatical ultrapassou os limites de um único trigêmeo (centenas+dezenas+unidades). As diferenças entre essas condições podem ser explicadas como uma representação sintática dentro do trigêmeo – por exemplo, uma representação que capitaliza o fato de que as três palavras em cada trigêmeo têm classes lexicais diferentes. A situação era diferente na condição A versus B: a única diferença entre essas duas condições era que a condição A, mas não a B, combinava palavras dos dois trigêmeos em um único segmento. B, os participantes criaram uma representação sintática de trigêmeos cruzados. Na Discussão Geral, voltamos às implicações deste financiamento.
A segunda conclusão diz respeito à automaticidade. Na condição A, a representação sintática de trigêmeos cruzados foi criada mesmo que não fosse benéfica – ela atrapalhava o desempenho. Isto sugere fortemente que a criação de uma representação sintática não resultou de uma decisão voluntária, consciente e estratégica, mas foi um processo automático.
A terceira conclusão diz respeito a se a representação sintática é recuperada como um modelo rígido ou criada dinamicamente por um processo generativo. Cowan (2001) propôs que existem pelo menos dois métodos diferentes de criação de chunks, e esses dois métodos diferem no limite que impõem ao tamanho do chunk. Um método é recuperar um modelo memorizado, que serve como base para o bloco, e incorporar vários itens únicos nesse modelo (cada item é uma representação da memória de longo prazo). Por exemplo, pode ser assim que jogadores de xadrez experientes codificam movimentos complexos. O número de itens nesses modelos às vezes pode ser muito grande – mais do que a capacidade padrão da memória de curto prazo de 3 a 4 itens – mas o modelo ainda é um único bloco. Um segundo método para criar blocos é formar novas associações ad hoc entre itens. Este método é mais dinâmico e flexível, mas o custo é que o tamanho do bloco está sujeito ao limite de capacidade da memória de trabalho de 3 a 4 itens. O ponto crítico é que esses dois métodos diferem nas restrições que impõem ao tamanho do bloco: o último método está sujeito a limites de capacidade de memória de trabalho, enquanto o primeiro não. Assim, em nosso experimento, se os pedaços sintáticos forem criados de maneira generativa, eles estarão sujeitos ao limite de capacidade da memória de trabalho, levando a um desempenho ruim em pedaços superdimensionados – exatamente o padrão que vemos na condição A. Se a estrutura sintática do número tivesse sido memorizada? modelo, os participantes poderiam ter criado pedaços baseados em modelos, que não estão sujeitos ao limite de capacidade, e o desempenho na condição A (com 1 pedaço por estímulo) deveria ter sido melhor do que na condição B (2 pedaços por estímulo). caso. Concluímos, portanto, que a estrutura sintática do número não foi recuperada como um modelo memorizado pré-definido, mas foi criada por um processo generativo em tempo real.
O chunking sintático indica genuinamente uma representação sintática
A fragmentação eficiente envolve dois aspectos principais do estímulo: detectabilidade e compressibilidade (Chekaf et al., 2016). O primeiro aspecto refere-se à detecção de regularidades no estímulo, o que fornece oportunidades para uma fragmentação eficaz, por exemplo, estabelecendo limites ideais de fragmentação. No nosso caso, isso se referiria à detecção dos segmentos gramaticais. O segundo aspecto refere-se ao processo que comprime os dados em um pedaço, presumivelmente contando com alguma representação com fortes associações entre os elementos do pedaço (Cowan, 2001). No nosso caso, a compressibilidade é presumivelmente impulsionada pela representação da sintaxe do número.
Interpretamos os resultados do Experimento 1 em termos de compressibilidade: Argumentamos que a diferença crítica entre as condições experimentais era que elas afetavam a capacidade dos participantes de criar pedaços baseados em sintaxe. Será que as condições diferiam entre si na detectabilidade dos segmentos gramaticais? No Experimento 1, intencionalmente não fornecemos nenhuma pista para chunking (para não dar nenhuma pista que possa afetar a detectabilidade), mas na ausência de tais pistas, os participantes podem ter recorrido a outras estratégias que poderiam dar origem a diferentes níveis de detectabilidade em diferentes condições. . Por exemplo, eles podem ter usado uma estratégia simples, como "fechar um pedaço" após cada palavra - uma estratégia que pode resultar em um pedaço mais eficiente na condição B do que na condição D. Alternativamente, eles podem ter usado estratégias abertas com base em seu conhecimento matemático formal, e tais estratégias podem ser mais fáceis de implementar nas condições gramaticais, que presumivelmente se adaptam melhor ao conhecimento formal do participante sobre números. Os efeitos da detectabilidade podem ter sido ainda mais amplificados pelo desenho bloqueado do Experimento 1, que pode permitir o desenvolvimento de estratégias específicas para cada bloco.
A comparação entre as condições A e B no Experimento 1 sugere que este não foi o caso, porque os participantes criaram uma representação sintática mesmo quando isso não deu resultado (na condição A). No entanto, projetamos os Experimentos 2 e 3 para refutar especificamente a interpretação alternativa. No Experimento 2, usamos um design misto para desencorajar estratégias específicas de bloco. No Experimento 3, fornecemos dicas claras sobre os limites dos blocos, para minimizar as diferenças de detectabilidade entre as condições.
Experimento 2: design misto
O projeto foi semelhante ao Experimento 1, mas aqui as diferentes condições foram misturadas em um único bloco. Este projeto deveria dificultar o uso de estratégias abertas porque os participantes não poderiam conhecer a estrutura sintática do estímulo específico até que ele fosse executado. Assim, seria difícil explicar um efeito de agrupamento sintático no Experimento 2 como resultante de estratégias exageradas.

Método
Foram 3 condições com 2, 3 ou 4 segmentos gramaticais por estímulo, com 4, 9 e 7 tentativas em cada condição, respectivamente. Todos os tipos de ensaios foram apresentados em bloco único, em ordem aleatória (mesma ordem para todos os participantes). Os participantes foram os mesmos que realizaram o Experimento 1; eles realizaram o Experimento 2 imediatamente antes ou depois do Experimento 1 (consulte a seção "Tarefa de agrupamento sintático"). Cada participante executou a versão 6-palavra ou 7-palavra da tarefa, como no Experimento 1. A codificação dos dados e a análise estatística foram como no Experimento 1, mas no modelo linear misto, o fator de condição foi um fator numérico entre estímulos em vez de um fator categórico dentro do estímulo. (Ainda estava dentro do participante.)

Resultados e discussão
Os resultados do Experimento 1 foram essencialmente replicados: o desempenho foi melhor nas condições com menos segmentos e mais longos (Fig. 5). O modelo linear misto mostrou que o efeito Condição foi significativo para a taxa de erro do morfema (Δ=2,2%, χ2=4,17, p=0,04) e a taxa de erro de classe (Δ =2,5%, χ2=5,09, p=0,02), embora não para a taxa de erro de dígito (Δ=1,9%, χ{{16} },48, p=0,12).
Esses resultados são difíceis de explicar como uma estratégia aberta. Para que tal estratégia aberta fosse eficaz, os participantes teriam que determinar sua estratégia em cada tentativa e fazê-lo somente após o estímulo ter sido executado, momento em que o desafio de memorização já havia começado. . A explicação melhor e mais provável é que as condições gramaticais foram vantajosas devido à fragmentação sintática.
Experimento 3: dicas abertas
Este experimento teve como objetivo específico descartar a detectabilidade de segmentos gramaticais como uma explicação do efeito de fragmentação sintática. Para esse fim, deixamos a detectabilidade de lado, tornando-a o mais fácil possível em todas as condições: demos aos participantes dicas claras e explícitas sobre como deveriam dividir a sequência de palavras em pedaços. Se a diferença entre as condições no Experimento 1 originou-se na detectabilidade de segmentos gramaticais, as pistas evidentes deveriam substituir quaisquer diferenças sutis específicas do estímulo, e o desempenho deveria ser semelhante entre as condições. Se, no entanto, os resultados do Experimento 1 resultaram da maior compressibilidade dos segmentos gramaticais, os resultados deveriam ser replicados aqui também.
Método
Os participantes foram 20 adultos com idades entre 19;6–52;7 (média=27;7, DP=7;9). O experimento incluiu apenas duas condições, idênticas (mesmos estímulos) às condições B (gramatical) e D (fragmentadas) do Experimento 1. Todos os participantes realizaram a 7-versão em palavras da tarefa. As condições foram administradas em dois blocos em ordem contrabalançada. O procedimento foi como no Experimento 1, exceto que agora fornecemos pistas claras para os limites dos pedaços. Criticamente, as dicas eram idênticas em ambas as condições (gramaticais e fragmentadas): em ambos os casos, os participantes foram instruídos a dividir cada estímulo em dois pedaços, um com 3 palavras e outro com 4 palavras. {14}}número de dígito começando com o dígito 1, seguido por um número de 3-dígito (por exemplo, mil duzentos e trinta e quatro; quinhentos e sessenta e cinco). Na condição fragmentada, a deixa dividiu o estímulo em duas partes do mesmo comprimento, mas nenhuma das partes era gramatical: a ordem das palavras foi invertida para evitar qualquer par de palavras gramaticalmente válido (cinco sessenta centenas; quatro trezentos mil).
Como dicas, usamos dois aspectos da entonação. Primeiro, o experimentador não disse as palavras numéricas em um ritmo fixo como no Experimento 1, mas como diríamos dois números: Não houve atraso entre as palavras dentro de cada parte do estímulo e um atraso de cerca de 1 s entre as duas partes do estímulo. Em segundo lugar, a última palavra de cada parte do estímulo foi dita em tom descendente (entonação típica das últimas palavras das frases), e todas as palavras anteriores foram ditas em entonação gorda. Para facilitar a atenção a essas dicas, os estímulos não foram reproduzidos a partir da gravação como no Experimento 1, mas foram ditos em tempo real pelo experimentador. A codificação dos dados e a análise estatística foram realizadas no Experimento 1.
Resultados e discussão
Os resultados do Experimento 1 foram essencialmente replicados: a taxa de erro do morfema, a taxa de erro de dígitos e a taxa de erro de classe foram menores na condição gramatical do que na condição fragmentada (Fig. 6a; com o LMM descrito na seção "Análise estatística" do Experimento 1, morfemas: Δ=12,3%, χ2=140,5, p<0.001; digits: Δ=12.1%, χ2=136.1, p<0.001; classes: Δ=10.8%, χ2=103.8, p<0.001). Even at the single-subject level, the morpheme error rate was lower in the grammatical condition than in the fragmented condition for every single participant (Additional file 1: Fig. S2).
É improvável que a diferença entre as duas condições, que existiu embora tenhamos fornecido pistas muito claras sobre como dividir cada estímulo em dois pedaços, tenha surgido de diferentes graus de detectabilidade do segmento gramatical nas duas condições. A interpretação mais provável desses resultados é que a condição gramatical, ao usar sintaxe numérica válida, permitiu maior compressibilidade da sequência numérica de palavras.
Experimento 4: a representação sintática pode lidar com estruturas irregulares variadas
Os experimentos 1 a 3 mostraram que os participantes representaram a estrutura sintática do número e a usaram como base para a fragmentação. A Experiência 4 examinou dois aspectos adicionais desta representação sintática: o seu âmbito, isto é, as estruturas sintáticas específicas que podem ser representadas, e a sua flexibilidade, isto é, a capacidade de mudar rapidamente de uma estrutura sintática para outra. Para isso, incluímos números com diversas estruturas sintáticas diferentes.
Escopo. Os experimentos 1–3 usaram um escopo limitado de números: todos os estímulos foram baseados em números que não incluíam nem 0 nem 1. Este projeto teve como objetivo evitar uma complexidade que pode surgir de números com 0 e 1, porque esses dois dígitos criar números verbais com estruturas sintáticas irregulares: em hebraico, semelhante ao inglês, o dígito 0 não é realizado verbalmente, e o dígito 1 na posição da década é realizado verbalmente como uma palavra de adolescentes em vez da palavra padrão de dezenas. Ao evitar 0 e 1, os Experimentos 1–3 incluíram apenas números com estruturas sintáticas regulares e nenhum número com estruturas irregulares. Em contraste, o Experimento 4 examinou se uma representação sintática seria criada também para números irregulares.

Flexibilidade. O segundo aspecto que examinamos é a flexibilidade dos mecanismos sintáticos. Nos Experimentos 1 e 3, todos os números de um determinado bloco tiveram a mesma estrutura sintática. O Experimento 2 teve um design misto, mas utilizou apenas uma pequena variedade de estruturas sintáticas. O Experimento 4 utilizou mais estruturas sintáticas e as apresentou em ordem aleatória, para que pudéssemos examinar se a representação sintática e os processos que a criam são flexíveis o suficiente para servir de base para o agrupamento sintático mesmo neste cenário mais exigente.
For more information:1950477648nn@gmail.com